Seedream 5.0
Non si limita a disegnare: prima ragiona
Seedream 5.0 utilizza un'architettura unificata sia per la generazione di immagini da testo che per le capacità di editing complete, integrando buon senso e capacità di ragionamento. Rispetto ai modelli precedenti Seedream 3.0 e SeedEdit 3.0, raggiunge progressi significativi negli effetti multimodali, velocità e usabilità.
Progressi chiave
Capacità rivoluzionarie
Sperimenta la prossima generazione di creazione di immagini alimentata dall'AI con controllo e qualità senza precedenti
Espansione multimodale
Supporta in modo flessibile input combinati di testo e immagini. Consente la generazione da testo a immagine e da immagine a immagine, l'editing di immagini, l'editing multi-immagine e la generazione di gruppo, con molte possibilità creative.
Estetica migliorata
Supporta trasferimento di stile artistico altamente flessibile, dal Barocco al Cyberpunk. Combina stili per creare estetiche completamente nuove con eccezionale appeal visivo.
Logica e comprensione
Sfrutta la conoscenza del mondo per comprendere meglio gli input multimodali. Non si limita a disegnare: prima ragiona, dimostrando capacità di ragionamento in fisica, rompicapi e fumetti.
Generazione 4K
Proporzioni adattive con supporto per dimensioni personalizzate. Risoluzione massima estesa da 2K a 4K, con proporzioni ottimali generate in base alle istruzioni o ai riferimenti.
10x più veloce
Attraverso design architettonico innovativo e accelerazione di distillazione estrema, la generazione di immagini DiT è oltre 10 volte più veloce di Seedream 3.0.
Leader del settore
Raggiunge risultati leader nelle valutazioni complete, con capacità chiave all'avanguardia del settore su tutti i benchmark.
Otto capacità fondamentali
Dalla generazione di immagini al motore creativo
Sbloccando nuove esperienze di creazione visiva oltre la tradizionale generazione di immagini
Editing preciso
Prestazioni eccellenti nell'editing di immagini con modifiche di alta qualità attraverso solo prompt testuali. Esegue precisamente operazioni di aggiunta, cancellazione, modifica e sostituzione mantenendo l'integrità complessiva dell'immagine. Perfetto per design pubblicitario, ritocco e-commerce e post-produzione, riducendo significativamente i costi di correzione manuale.
Riferimento flessibile
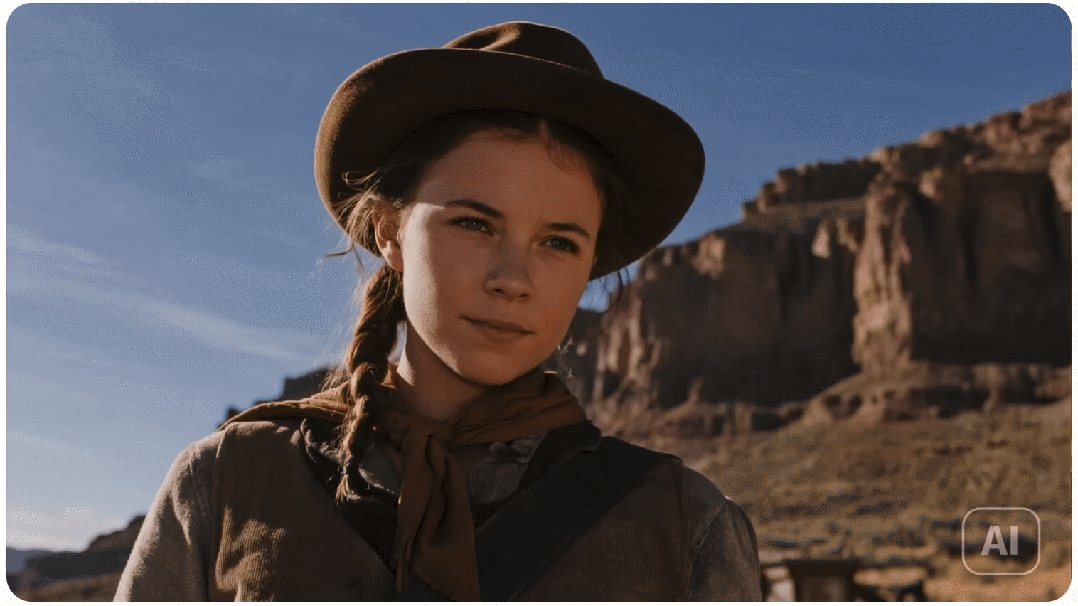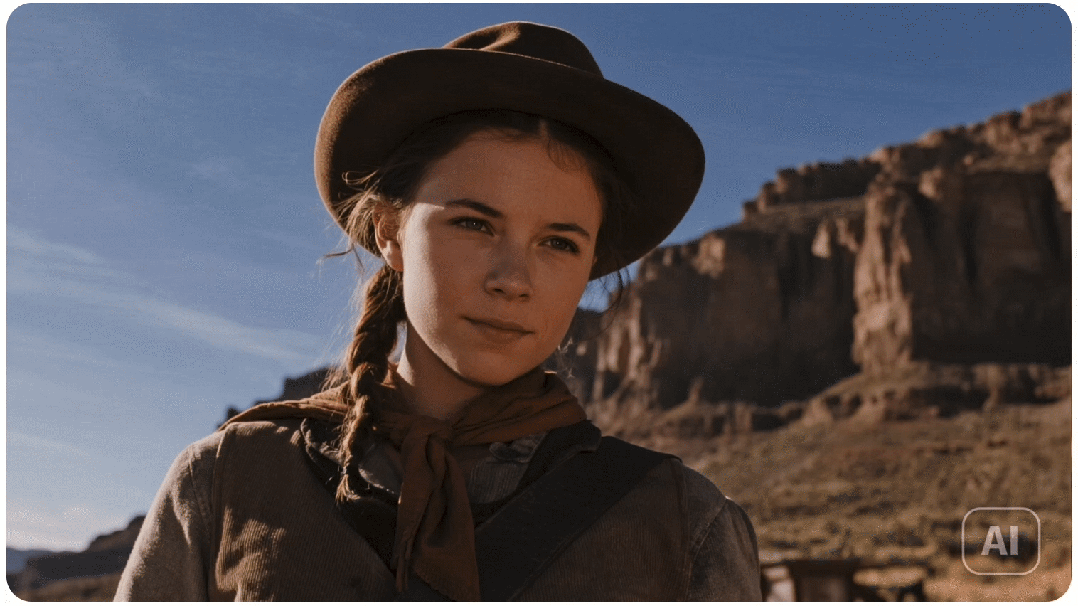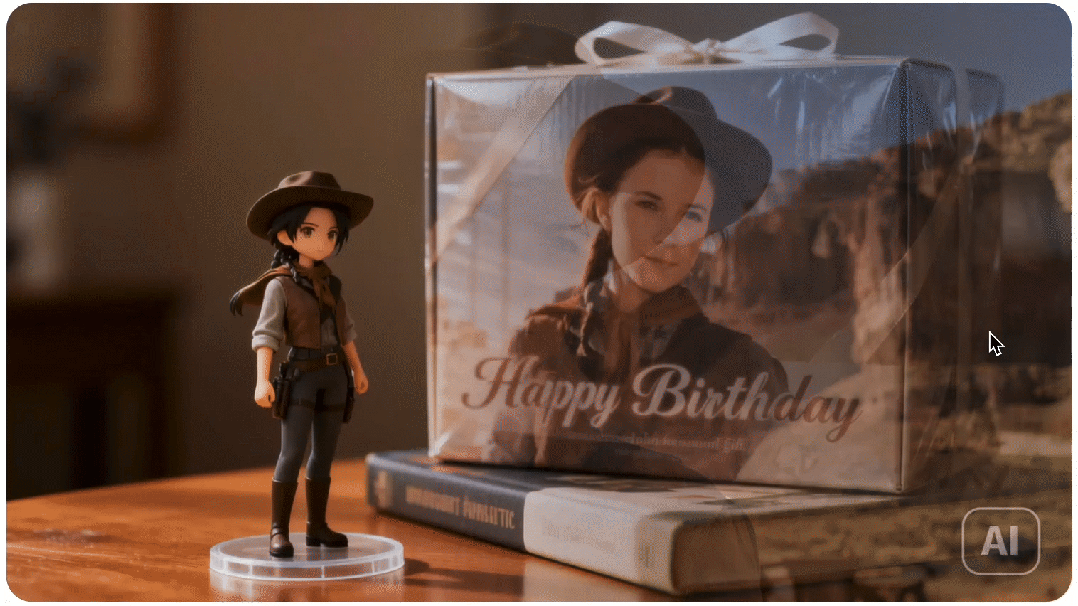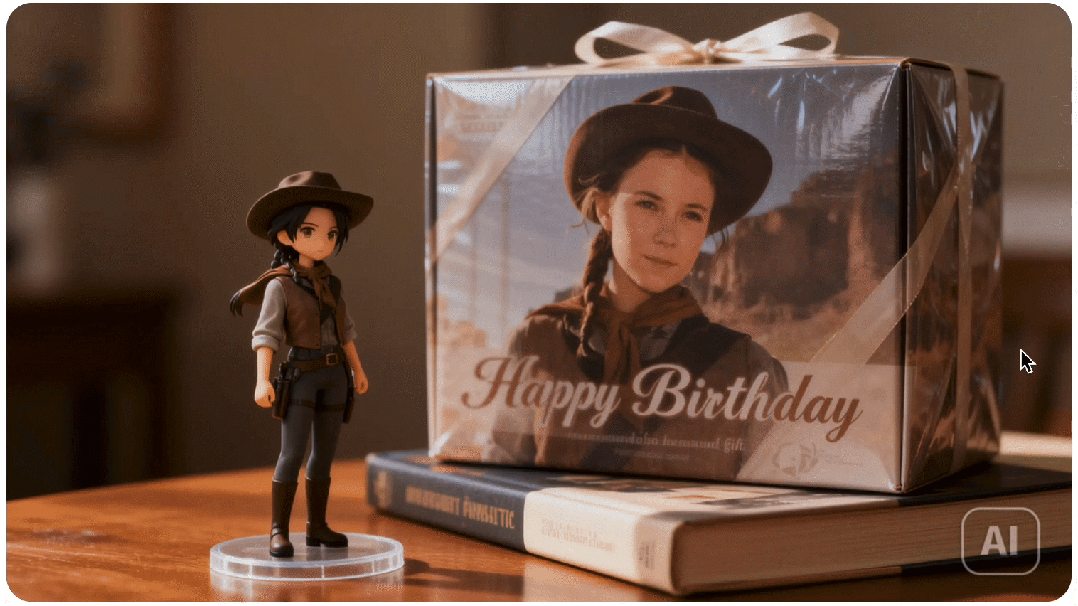
Trova l'equilibrio perfetto tra conservazione e creazione. Estrae informazioni chiave dalle immagini di riferimento come identità del personaggio, stile artistico o caratteristiche strutturali, poi ricrea in contesti completamente nuovi. Ideale per creazione di avatar virtuali, design derivato e creazione secondaria.
Controllo segnali visivi
Integrazione nativa di segnali visivi Canny, Depth, Mask e altri senza modelli aggiuntivi. Gli utenti possono guidare la generazione di immagini attraverso schizzi semplici, scarabocchi o linee ausiliarie. Essenziale per controllo pose, design architettonico e generazione prototipi UI.
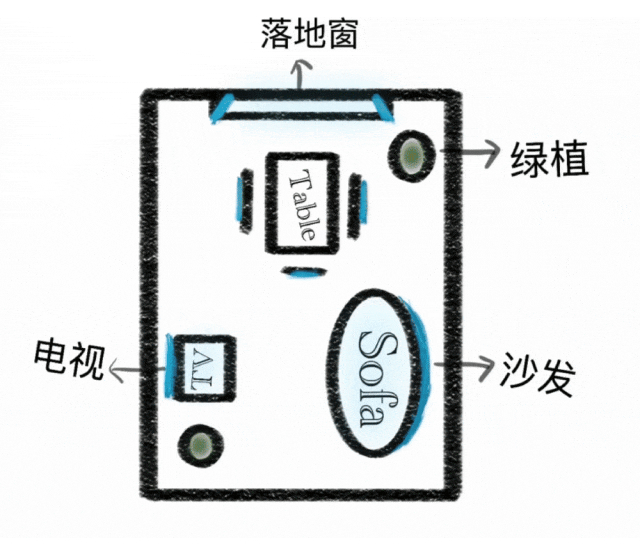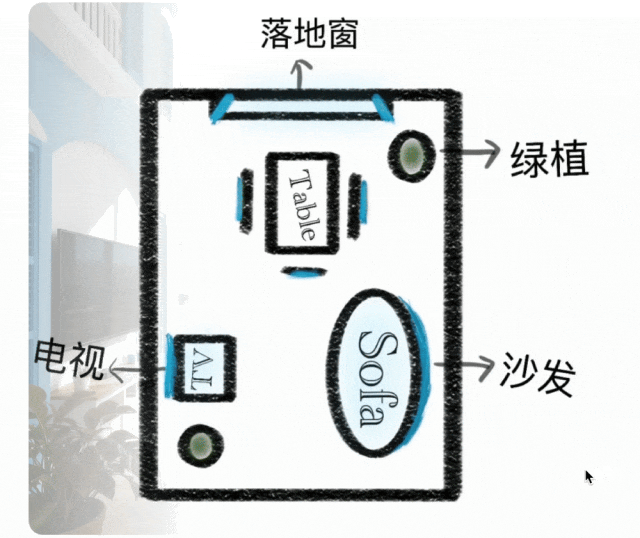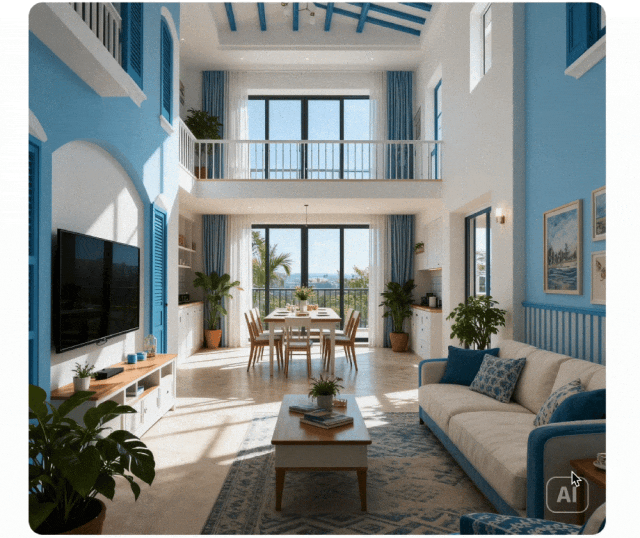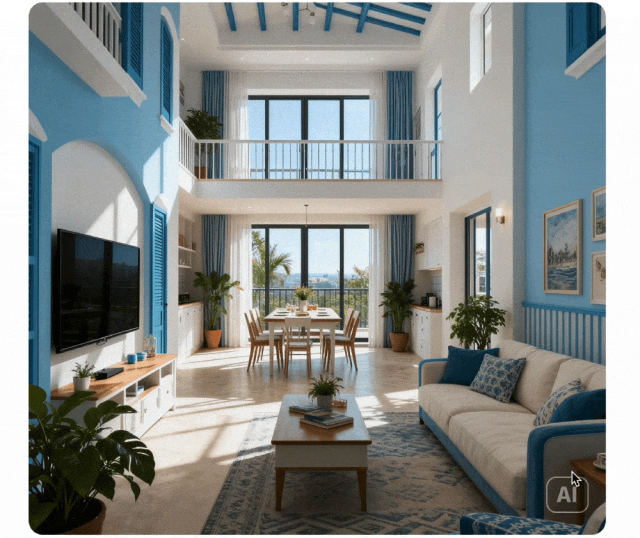
Ragionamento nel contesto
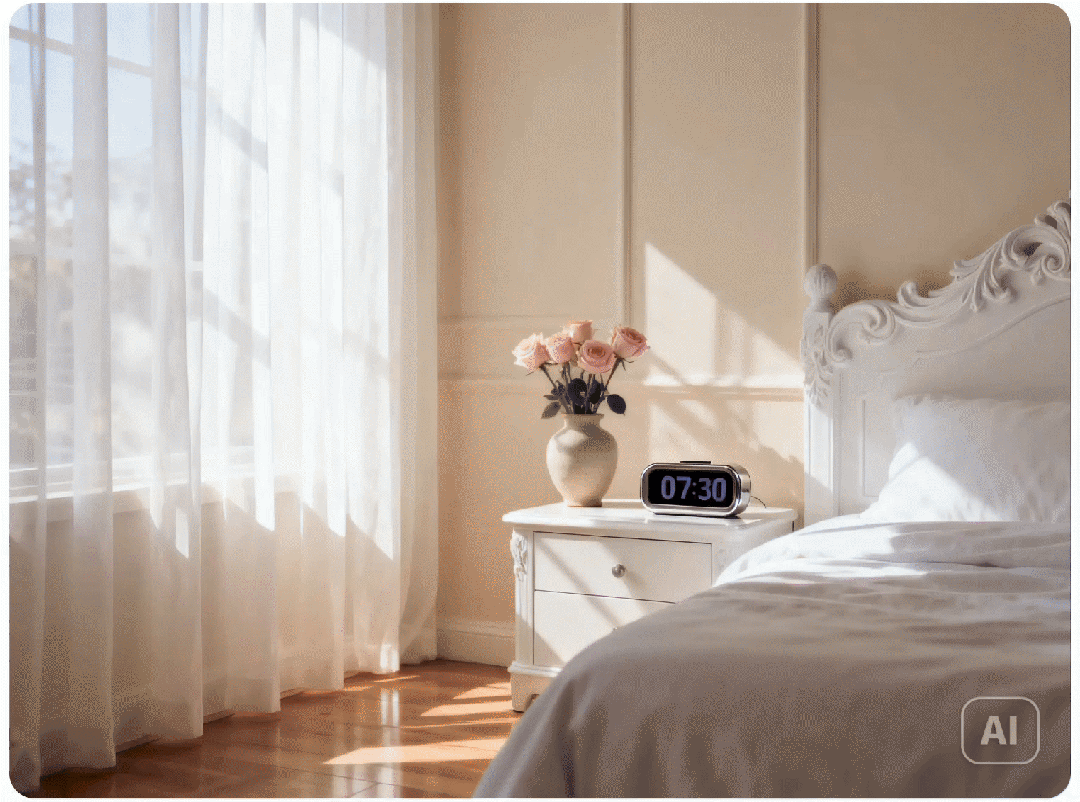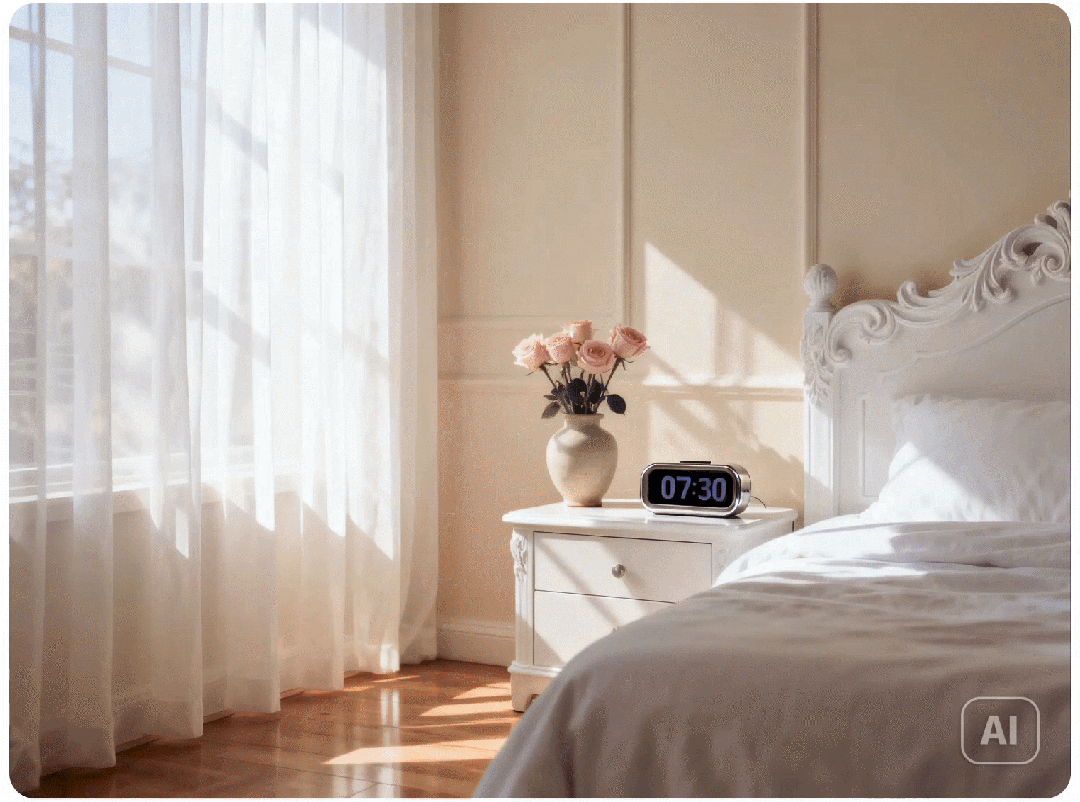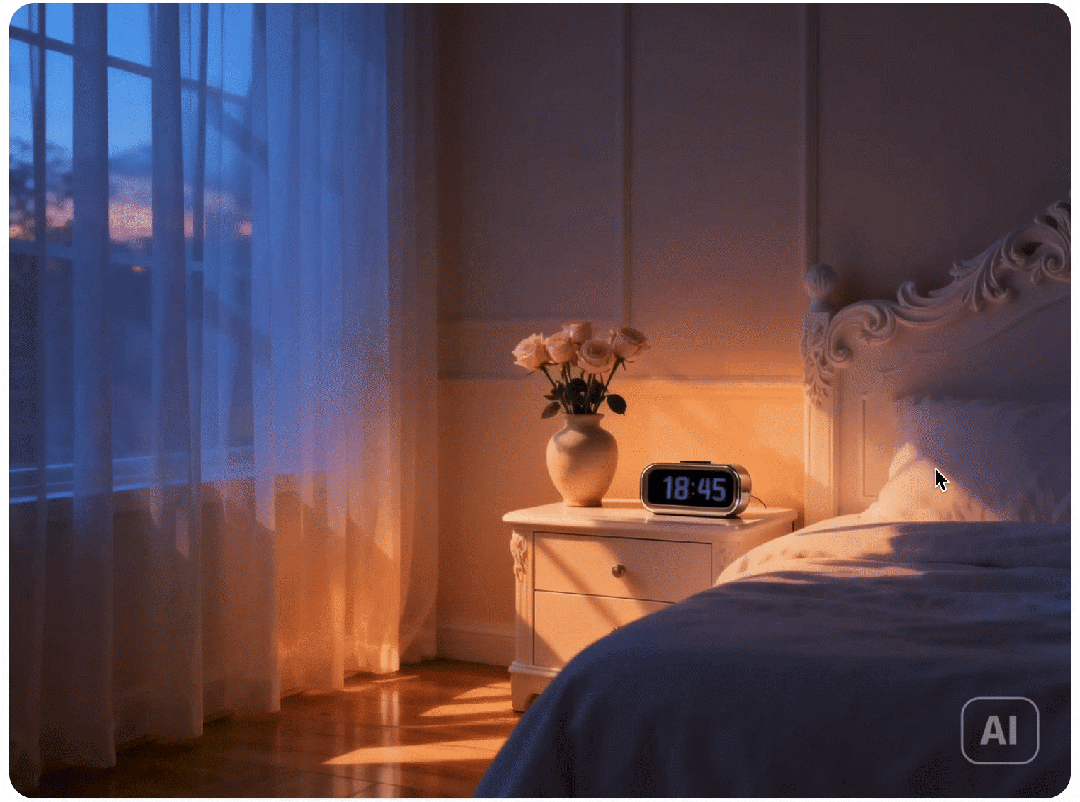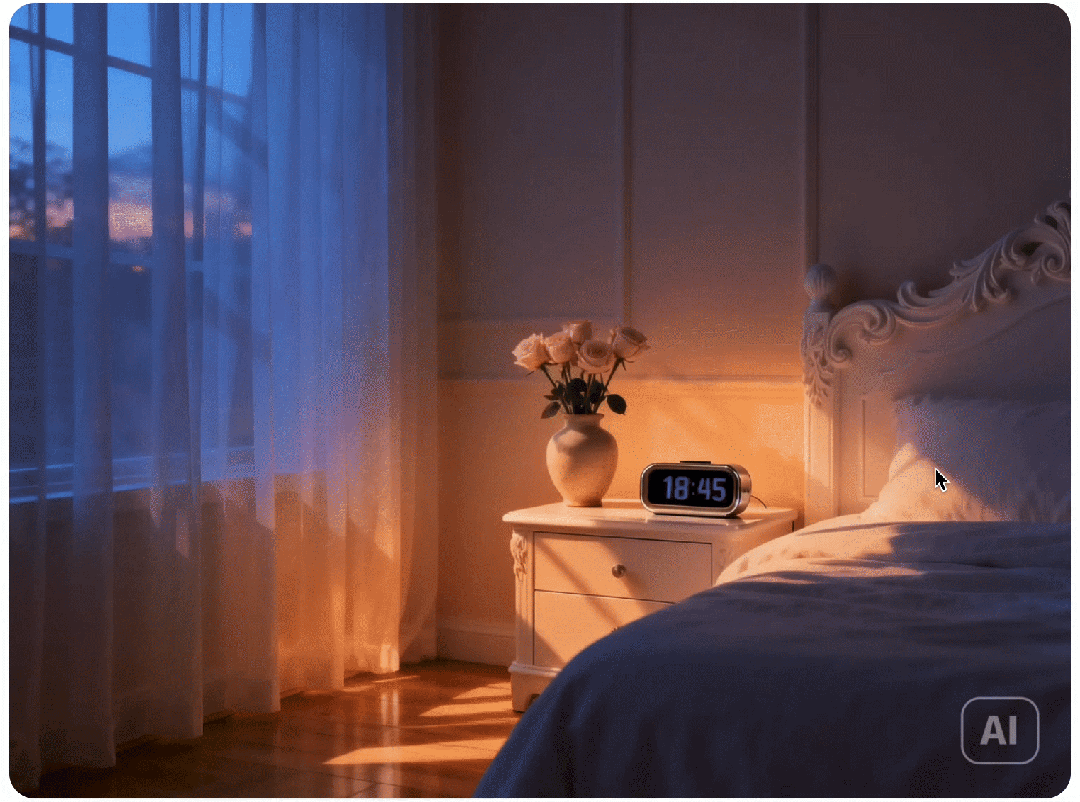
Paradigma di generazione espanso dalla semplice esecuzione di istruzioni alla generazione di ragionamento nel contesto. Comprende vincoli fisici e temporali, spazio 3D e contesti complessi. Mantiene coerenza di stile e dettagli fini in puzzle, cruciverba e continuazioni di fumetti.
Riferimento multi-immagine
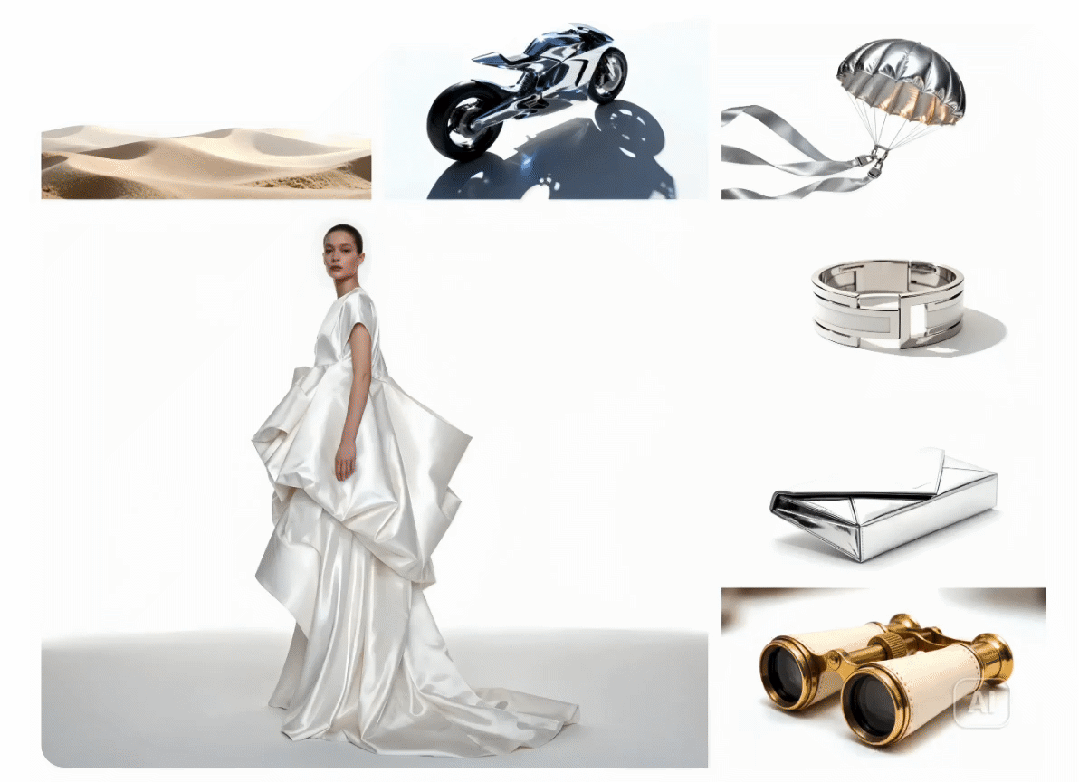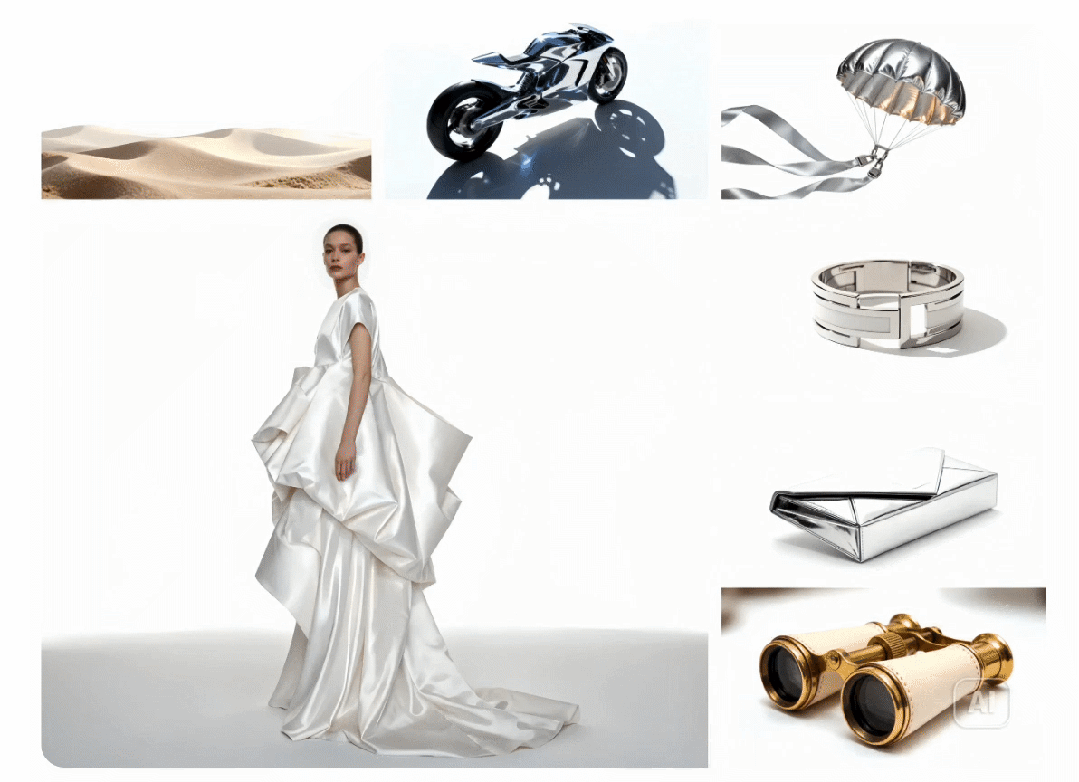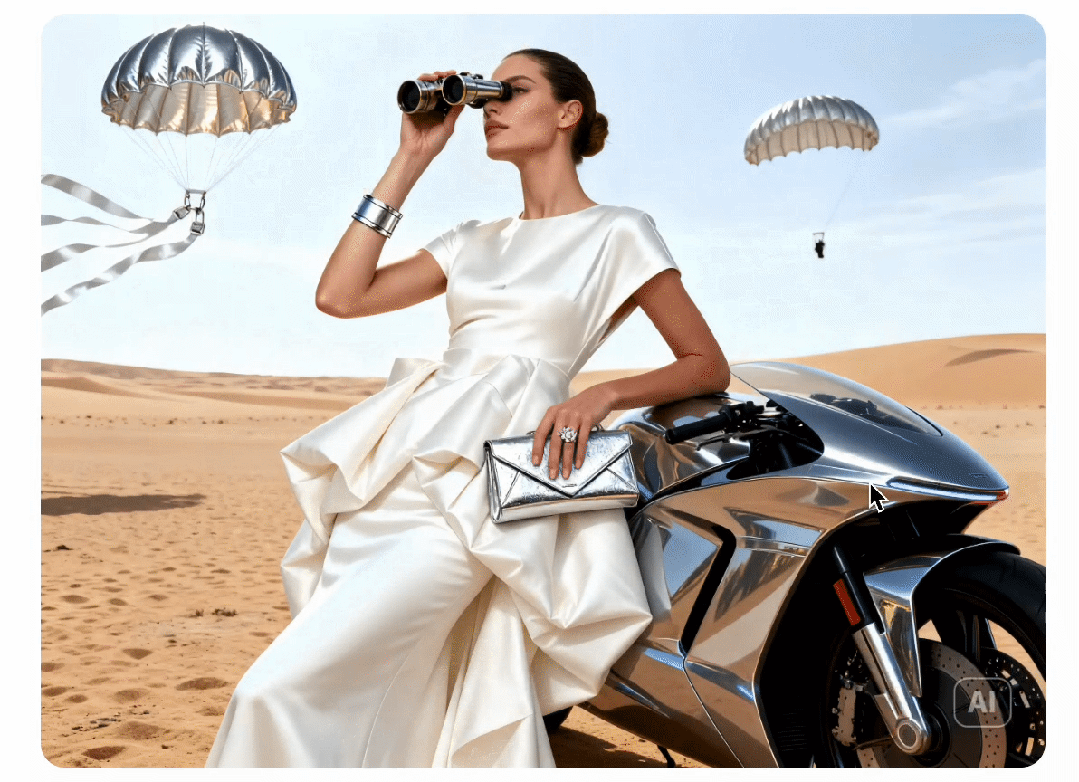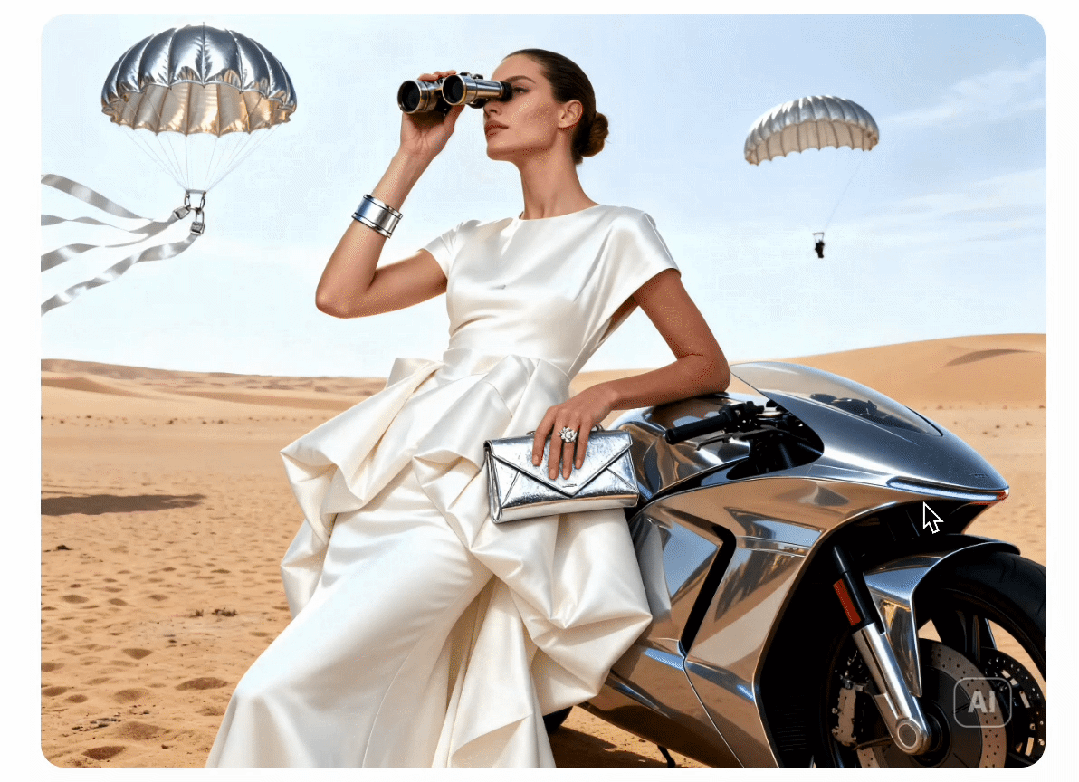
Supporta fino a una dozzina di immagini di riferimento contemporaneamente, estraendo tratti dei personaggi, stili delle scene e strutture degli oggetti per fonderli in modo organico. Perfetto per la prova virtuale di capi o per combinare parti in strutture meccaniche complete mantenendo proporzioni e coerenza fisica.
Output multi-immagine
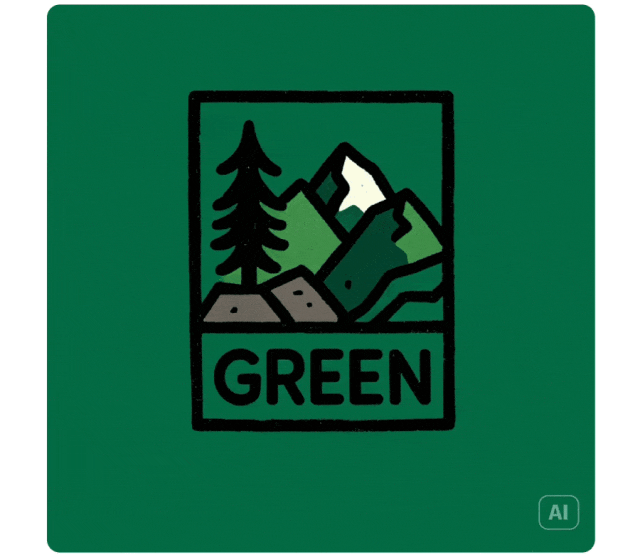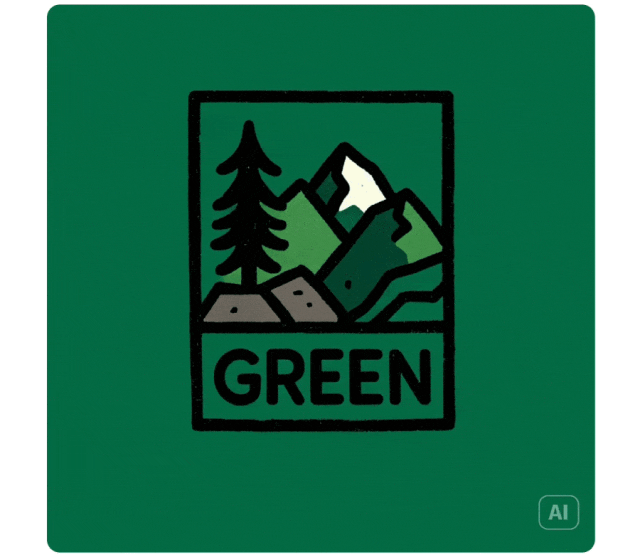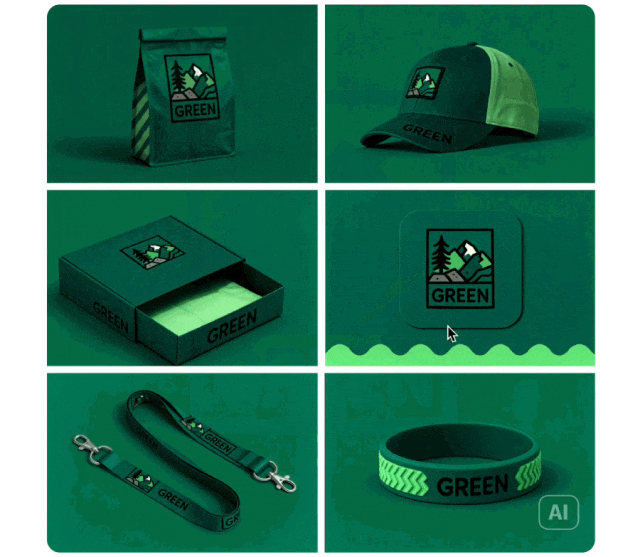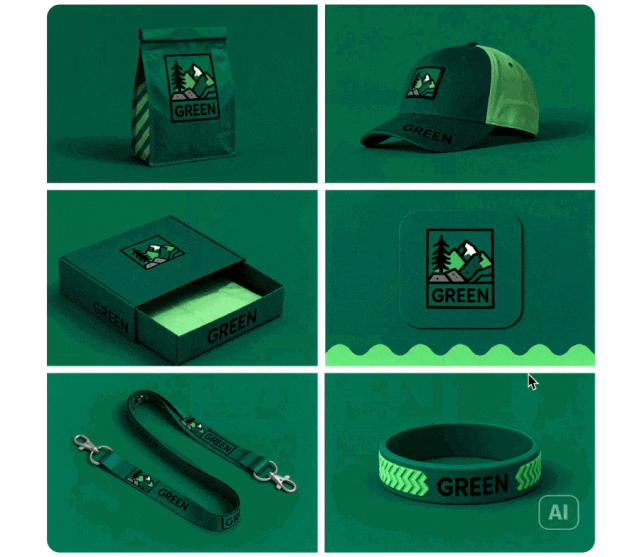
Genera multiple immagini in una operazione con pianificazione globale e coerenza contestuale. Crea sequenze di personaggi coerenti con stile unificato, perfetto per storyboard, creazione di fumetti e set di design coesi come prodotti IP o pacchetti di adesivi.
Rendering testo avanzato
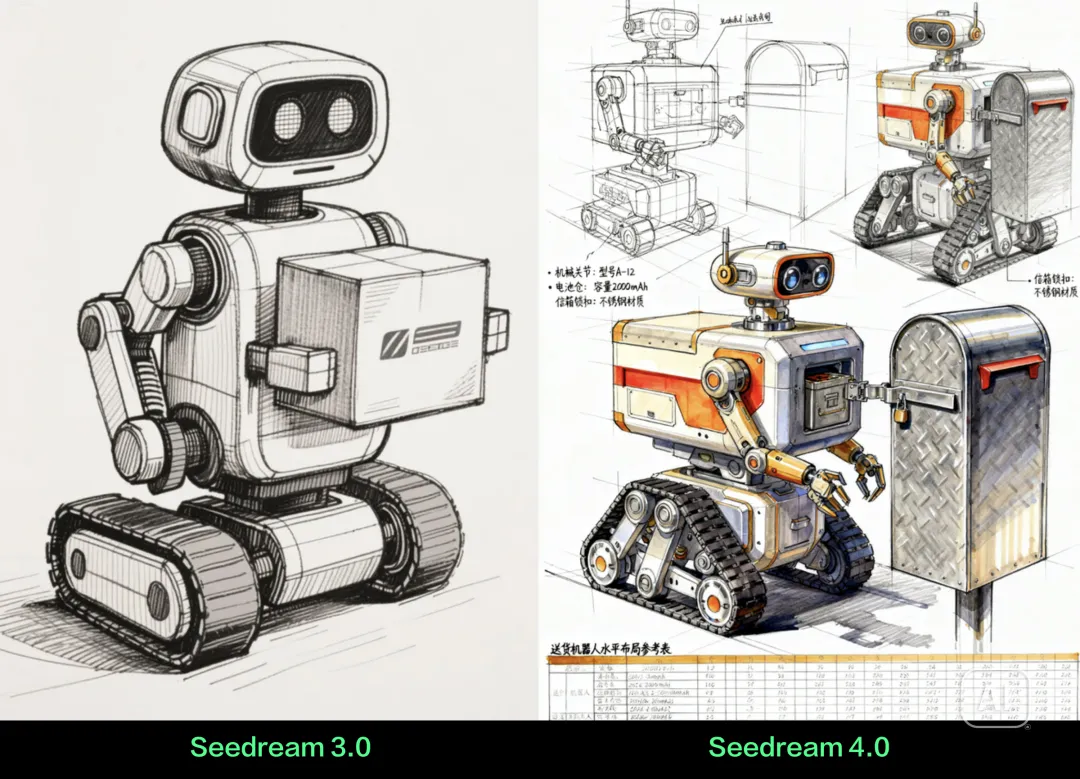
Una svolta nell'elaborazione del testo per i modelli di generazione. Non solo rende il testo in modo chiaro e corretto, ma gestisce anche formule, tabelle, strutture chimiche e grafici statistici. Ideale per contenuti ad alta densità informativa come materiale didattico e illustrazioni accademiche.
Rapporto Adattivo e 4K
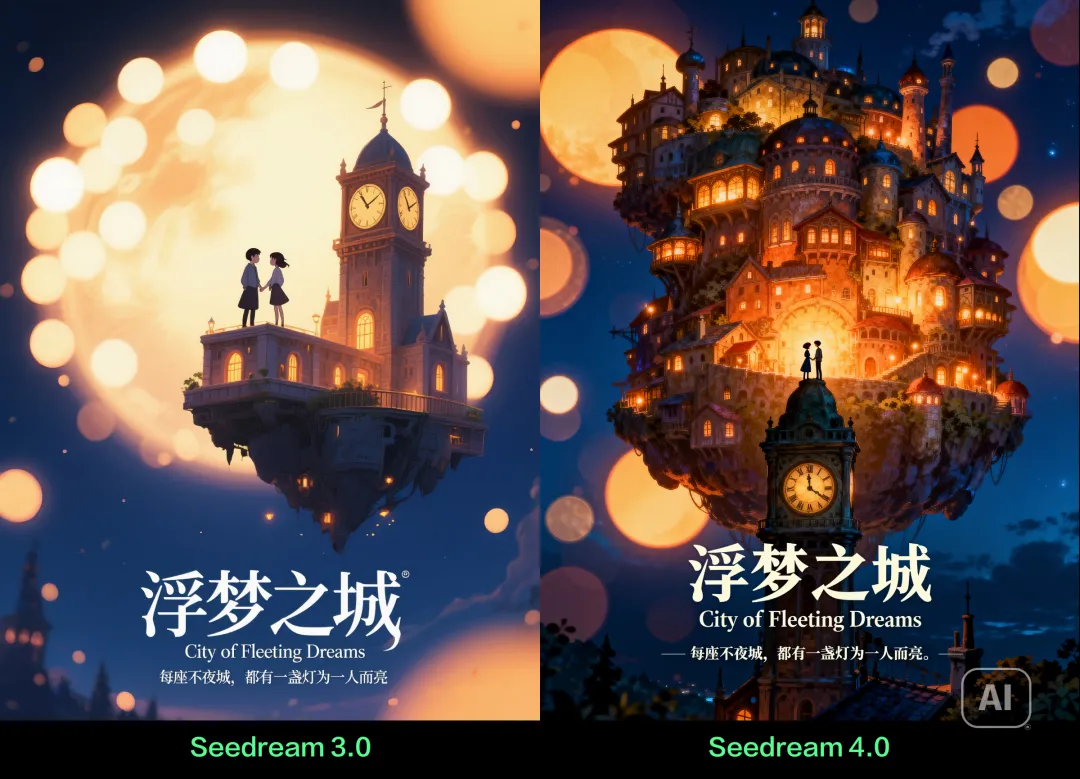
Meccanismo di rapporto d'aspetto adattivo regola automaticamente la tela basata su esigenze semantiche o forme di riferimento. Supporta dimensionamento personalizzato con risoluzione espansa a 4K ultra-alta definizione, raggiungendo standard di applicazione commerciale con composizioni più estetiche.
Technical Innovation
Unified Architecture, Superior Performance
Joint training of generation and editing enhances complex task generalization
Unified Generation & Editing
- •Integrates Seedream text-to-image and SeedEdit capabilities in one architecture
- •Perceives text prompts and reference images across different modalities
- •Maintains high-quality generation with high-consistency feature reference
Efficient Model Architecture
- •Carefully designed Diffusion Transformer with new high-compression VAE
- •10x faster training and inference compared to Seedream 3.0
- •Excellent efficiency and scalability in modality and task coverage
Enhanced Multimodal Understanding
- •Fine-tuned SeedVLM model for high-performance multimodal understanding
- •Leverages VLM's world knowledge to expand input prompts
- •Large-scale multimodal data processing pipeline
Inference Optimization
- •Adversarial distillation for stable few-step inference
- •4/8-bit mixed quantization with offline smoothing
- •Speculative decoding reduces inference latency significantly
Industry-Leading Performance
Comprehensive Evaluation Results
Leading in aesthetics, text rendering, and other core metrics
Text-to-Image Generation
Comprehensive improvements over the previous version across all dimensions. Excels in instruction following, structural stability, and visual aesthetics. Particularly enhanced dense text rendering and complex semantic understanding capabilities.
Superior image quality, natural lighting, and color coordination compared to GPT-Image-1 and other models
Single Image Editing
Deep fusion of generation and editing with comprehensive improvements over SeedEdit 3.0. Achieves balance in instruction following, reference consistency, structural integrity, and text editing. Flexibly completes complex tasks like style transfer and perspective changes while maintaining image stability.
#1 in MagicArena comprehensive Elo scoring, surpassing Seedream 4.5